- 13 listopada 2026
- Posted by: Damian
- Category: Baza wiedzy
W tym artykule poznasz trzy ważne elementy języka SQL: GROUP BY, HAVING oraz COUNT. Dowiesz się, jak łączyć rekordy w grupy, zliczać wystąpienia poszczególnych wartości oraz filtrować wyniki na podstawie obliczonych statystyk. Pokażemy Ci również, czym różni się HAVING od WHERE i w jakich sytuacjach należy stosować każde z tych poleceń.
Agregowanie danych w SQL – obliczanie różnych statystyk
W SQL dostępne są funkcje agregujące, które pozwalają na obliczanie różnych statystyk na podstawie danych.
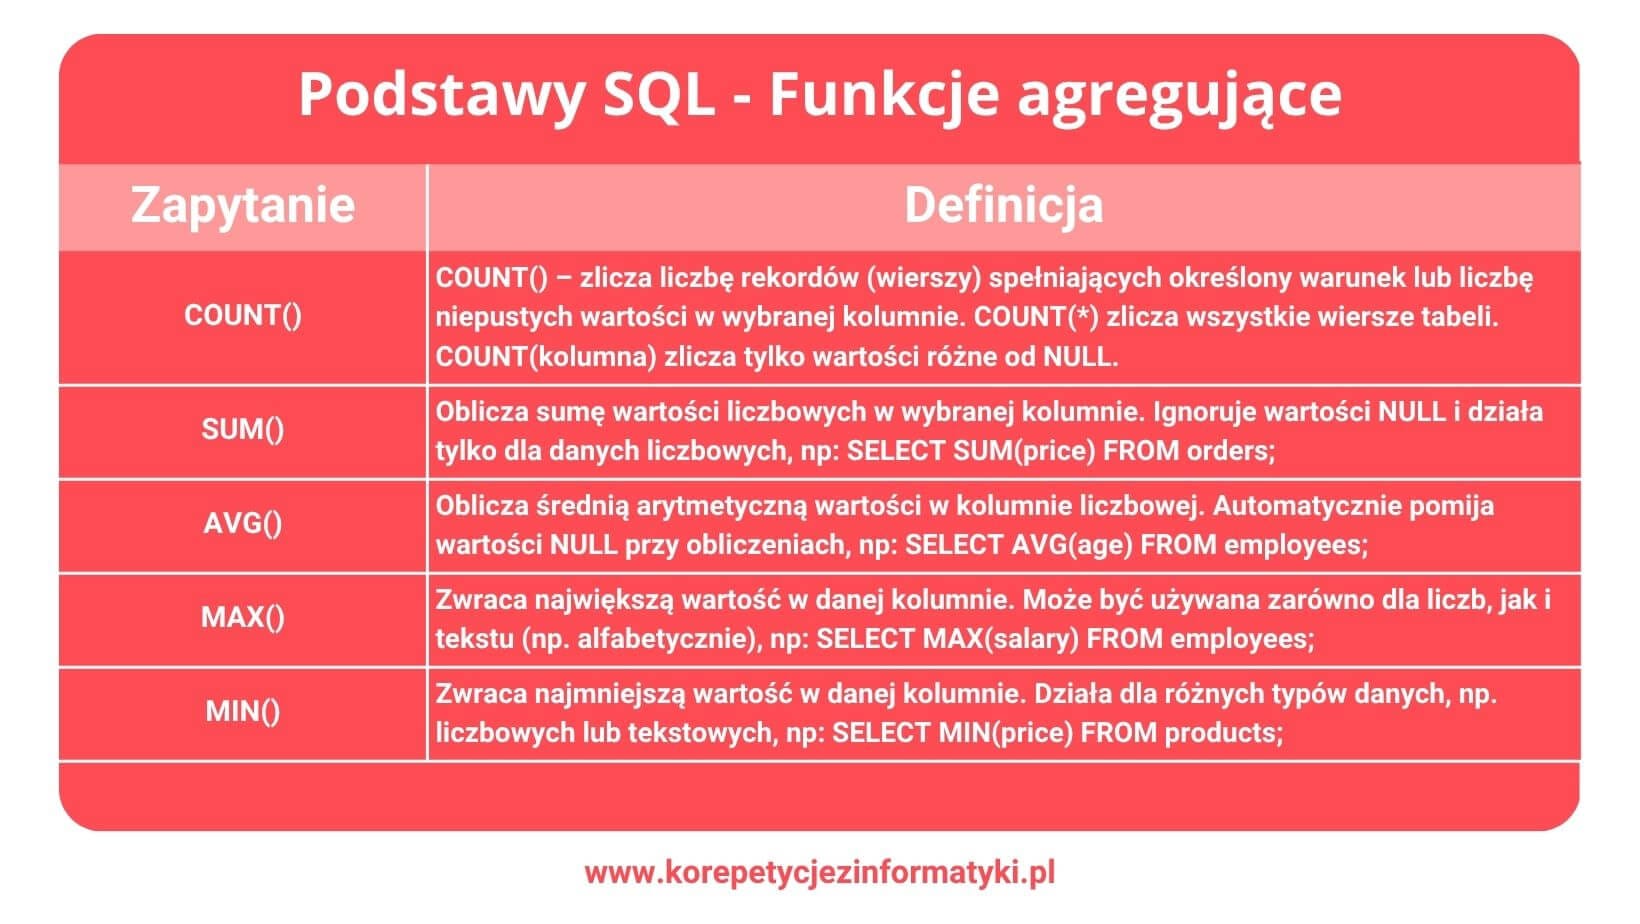
Są to funkcje takie jak:
- COUNT() – zlicza liczbę rekordów,
- SUM() – sumuje wartości,
- AVG() – oblicza średnią,
- MAX() – zwraca największą wartość,
- MIN() – zwraca najmniejszą wartość.
Przykłady będą bazować na tych tabelach:
| id_pracownik | imie | nazwisko | stanowisko | dzial | pensja |
| 1 | Jan | Kowalski | Programista | 1 | 6000 |
| 2 | Janina | Kowalska | Rekruterka | 2 | 6000 |
| 3 | Jan | Kowalski | Sprzedawca | 3 | 4000 |
| 4 | Michał | Nowak | Programista | 1 | 30000 |
| 5 | Andrzej | Polak | Ksiegowy | 4 | 3000 |
| 6 | Karol | Nowakowski | Sprzatajacy | NULL | 4000 |
| dzial_id | nazwa |
| 1 | IT |
| 2 | HR |
| 3 | Marketing |
| 4 | Ksiegowosc |
| 5 | Zarzad |
Przykład funkcji COUNT w SQL:
1 2 3 | SELECT COUNT(*) FROM pracownicy WHERE stanowisko = 'Sprzatajacy'; |
Wynik:
Pole1
1
Kwerenda ta zwróci liczbę pracowników, którzy są sprzątaczami.
Gdybyśmy zamiast * w COUNT dali nazwę kolumny, nie zostaną policzone wiersze gdzie wartość w kolumnie to NULL.
1 2 3 | SELECT COUNT(dzial) FROM pracownicy WHERE stanowisko = 'Sprzatajacy'; |
Wynik:
Pole1
0
Grupowanie wyników z GROUP BY
Kiedy mamy do czynienia z danymi, które muszą być zgrupowane (np. sumy, średnie, liczba elementów w grupach), używamy klauzuli GROUP BY.
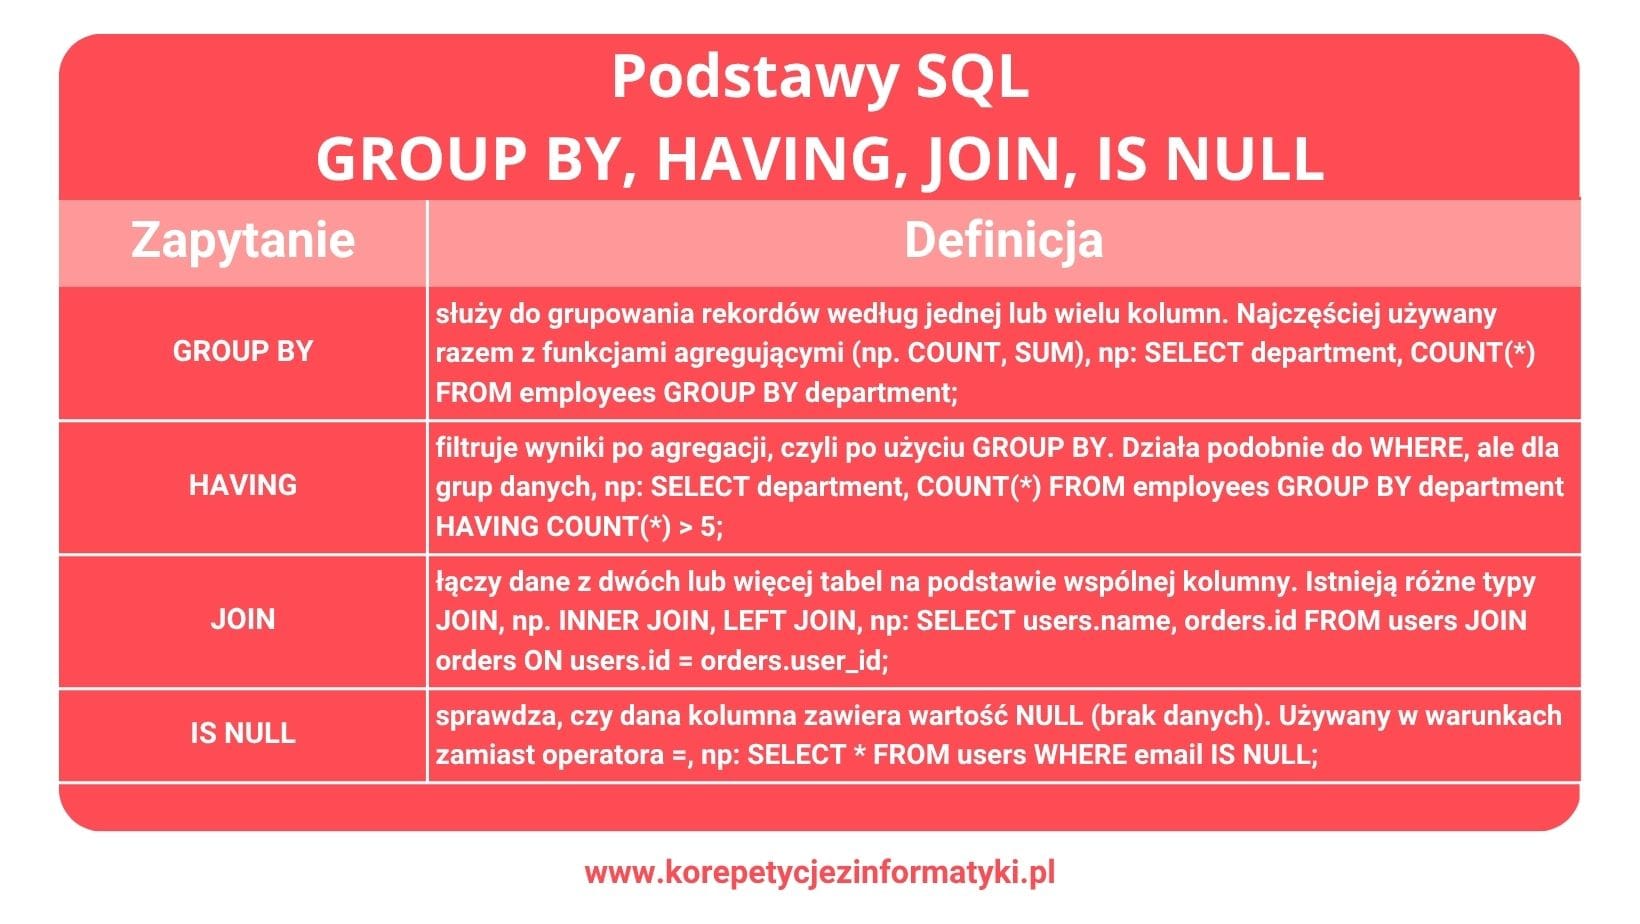
Przykład użycia GROUP BY:
1 2 3 | SELECT stanowisko, AVG(pensja) FROM pracownicy GROUP BY stanowisko; |
Ta kwerenda obliczy średnią pensję dla każdego stanowiska w tabeli pracownicy. Klauzula GROUP BY dzieli wyniki na grupy na podstawie wartości w określonej kolumnie (w tym przypadku stanowisko).
Wynik:
stanowisko pole1
Programista 18000
Rekruterka 6000
Sprzedawca 4000
Ksiegowy 3000
Sprzatajacy 4000
Bez GROUP BY:
stanowisko pole1
Programista 6000
Rekruterka 6000
Sprzedawca 4000
Programista 30000
Ksiegowy 3000
Sprzatajacy 4000
Jak widać bez GROUP BY nie “łączymy” tych samych stanowisk, liczymy średnią dla każdego stanowiska osobno
HAVING – filtrowanie wyników z GROUP BY
Klauzula HAVING w SQL jest używana do filtrowania wyników po ich zgrupowaniu za pomocą klauzuli GROUP BY. W przeciwieństwie do klauzuli WHERE, która filtruje wiersze przed grupowaniem, HAVING filtruje grupy wierszy po ich zgrupowaniu. Klauzula HAVING występuje po klauzuli GROUP BY w zapytaniu SQL.
1 2 3 4 | SELECT dzial, AVG(pensja) FROM pracownicy GROUP BY dzial HAVING AVG(pensja) > 5000; |
Wynik:
stanowisko pole1
Programista 18000
Rekruterka 6000
Łączenie tabel za pomocą JOIN
W SQL często zachodzi potrzeba pobrania danych z więcej niż jednej tabeli. W tym celu używamy operatorów JOIN, które pozwalają łączyć tabele na podstawie wspólnych kolumn.
Najczęściej używane rodzaje JOIN to:
- INNER JOIN (lub JOIN) – zwraca tylko te wiersze, które mają pasujące dane w obu tabelach,
- LEFT JOIN (lub LEFT OUTER JOIN) – zwraca wszystkie wiersze z lewej tabeli i pasujące wiersze z prawej tabeli,
- RIGHT JOIN (lub RIGHT OUTER JOIN) – zwraca wszystkie wiersze z prawej tabeli i pasujące wiersze z lewej tabeli.
Przykład z INNER JOIN:
1 2 3 4 | SELECT pracownicy.imie, pracownicy.nazwisko, dzialy.nazwa FROM pracownicy INNER JOIN dzialy ON pracownicy.dzial_id = dzialy.id; |
Ta kwerenda łączy dwie tabele: pracownicy i dzialy, na podstawie wspólnej kolumny dzial_id w tabeli pracownicy i id w tabeli dzialy. Zwróci imiona, nazwiska pracowników oraz nazwy działów, w których pracują.
Wynik:
imie nazwisko dzial
Jan Kowalski IT
Janina Kowalska HR
Jan Kowalski Marketing
Michał Nowak IT
Andrzej Polak Ksiegowosc
IS NULL – sprawdzenie czy wartość jest równa NULL
Klauzula IS NULL w SQL jest używana do sprawdzania, czy wartość w kolumnie jest równa NULL. NULL w bazach danych oznacza brak wartości lub wartość nieznaną. Nie jest to to samo co zero, pusty ciąg znaków czy jakakolwiek inna wartość.
1 2 3 | SELECT imie, nazwisko FROM pracownicy WHERE numer_dzialu IS NULL; |
Wynik:
imie nazwisko
Karol Nowakowski
Jest to szczególnie przydatne w połączeniu z LEFT/RIGHT JOIN. Wartości NULL pojawią się wtedy gdy wartość z jednej tabeli nie pojawia się w drugiej.
Przykładowo zadanie:
Wyświetl wszystkie działy w których nie pracuje żaden programista.
1 2 3 4 | SELECT Działy.nazwa_działu FROM Działy LEFT JOIN Pracownicy ON Działy.id_działu = Pracownicy.id_działu AND Pracownicy.stanowisko = 'Programista' WHERE Pracownicy.id_pracownika IS NULL; |
Wynik:
nazwa
HR
Marketing
Ksiegowosc
Zarzad
Podzapytania w SQL
Podzapytania to kwerendy (zapytania), które są zagnieżdżone w innych kwerendach (zapytaniach).
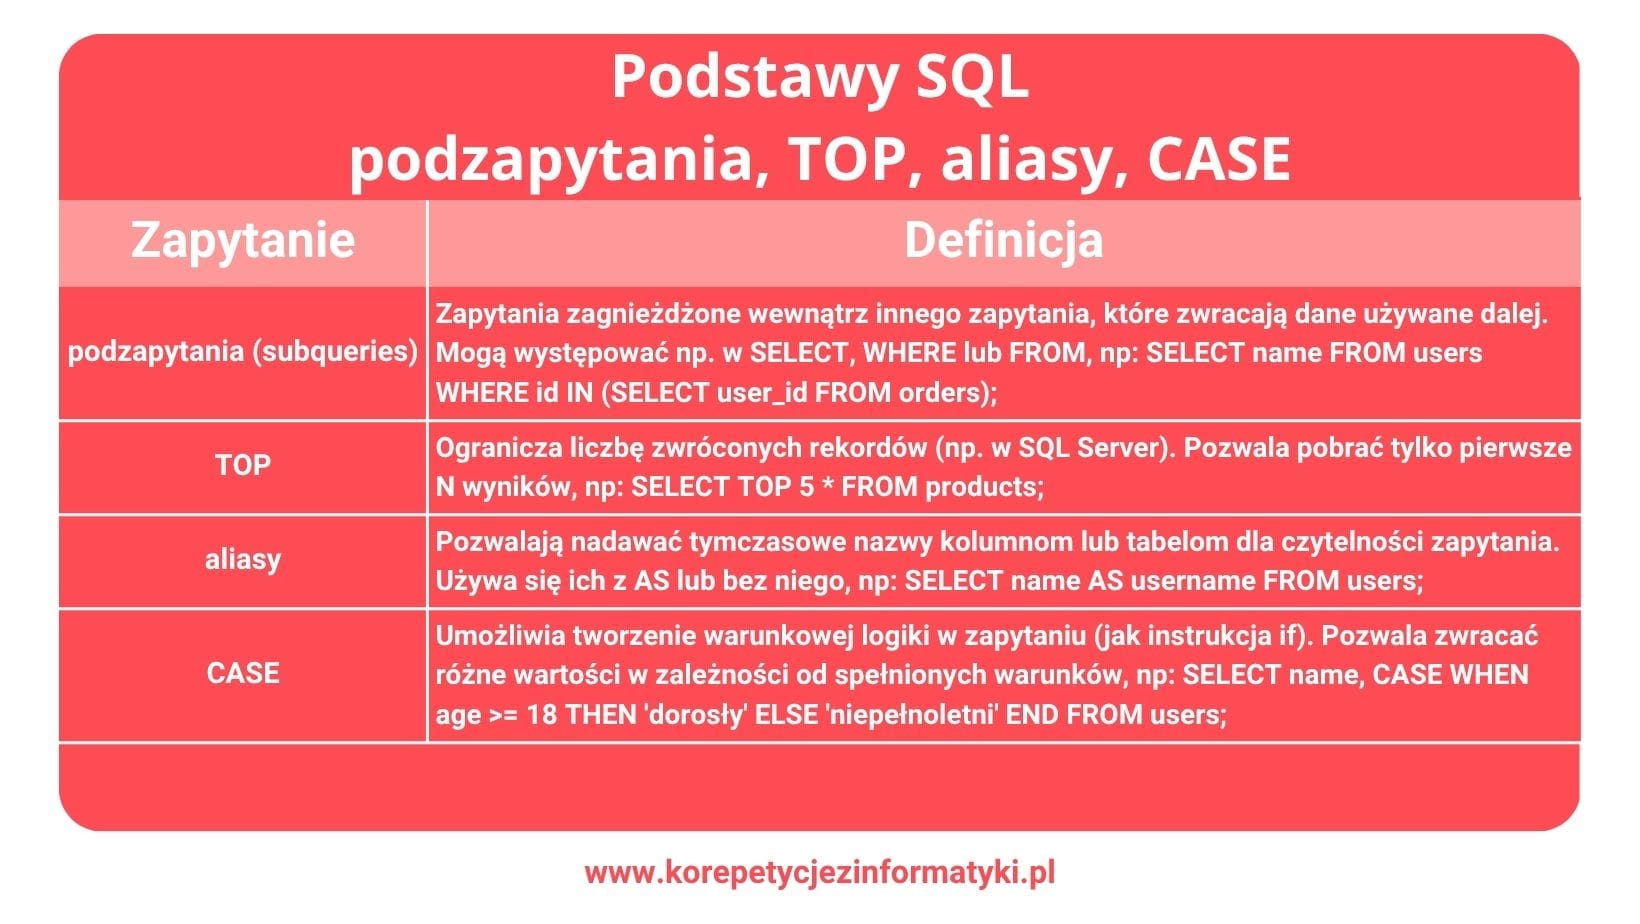
Można je stosować w klauzulach SELECT, WHERE oraz FROM. Przykład podzapytania w klauzuli WHERE:
1 2 3 | SELECT imie, nazwisko, pensja FROM pracownicy WHERE pensja > (SELECT AVG(pensja) FROM pracownicy); |
Wynik:
imie nazwisko pensja
Michał Nowak 30000
W tym przypadku kwerenda zwraca pracowników, których pensja jest wyższa niż średnia pensja w całej firmie.
TOP – ograniczenie liczby zwracanych wyników z zapytania SQL
W SQL możemy ograniczyć liczbę zwróconych wyników, używając klauzuli TOP.
Przykład:
1 2 3 | SELECT top 2 imie, nazwisko FROM pracownicy ORDER BY pensja DESC |
Ta kwerenda zwraca 2 pracowników o najwyższych pensjach.
Wynik:
Imie nazwisko
Michał Nowak
Jan Kowalski
Nie ma gwarancji, który z 2 pracowników zarabiajacych 6000 zostanie zwrócony
Aliasy – alternatywne nazwy dla kolumn w bazie danych
W SQL, słowo kluczowe AS służy do nadawania aliasów (alternatywnych nazw) kolumnom, tabelom lub wyrażeniom w zapytaniu. Użycie AS sprawia, że wyniki zapytania są bardziej czytelne i zrozumiałe. Przykłady znajdziesz poniżej.
Alias dla kolumny:
1 2 | SELECT imie AS i, nazwisko AS n FROM pracownicy; |
W tym przypadku kolumny imie i nazwiskoi zostaną wyświetlone jako i i n.
Wynik:
i n
Jan Kowalski
Janina Kowalska
Jan Kowalski
Michał Nowak
Andrzej Polak
Karol Nowakowski
Alias dla tabeli:
1 2 | SELECT p.imie, p.nazwisko FROM pracownicy AS p; |
Tabela pracownicy jest teraz aliasowana jako p, co upraszcza zapis w zapytaniach.
AS jest opcjonalne w przypadku aliasów, ale jego stosowanie może poprawić czytelność i zrozumienie zapytań. Jest to szczególnie przydatne gdy piszemy kwerendę, używając wielu tabel.
Instrukcje warunkowe CASE
W SQL można tworzyć podstawowe operacje warunkowe, czyli zwracać wyniki, które spełniają określone warunki.
1 2 3 4 5 6 7 | SELECT imie, nazwisko, pensja, CASE WHEN pensja < 3500 THEN 'Niska' WHEN pensja BETWEEN 3500 AND 7000 THEN 'Średnia' ELSE 'Wysoka' END AS kategoria_pensji FROM pracownicy; |
Można tworzyć dzięki nim podstawowe kwerendy krzyżowe
Wynik:
imie nazwisko pensja kategoria_pensji
Jan Kowalski 6000 Średnia
Janina Kowalska 6000 Średnia
Jan Kowalski 4000 Średnia
Michał Nowak 30000 Wysoka
Andrzej Polak 3000 Niska
Karol Nowakowski 4000 Średnia
Najczęściej zadawane pytania o funkcje agregujące oraz inne elementy SQL:
Czy w SQL można grupować według liczby?
Tak, w SQL można grupować dane według wartości liczbowych, np. wieku, ceny czy ilości. Jeśli dana kolumna zawiera liczby, GROUP BY potraktuje każdą unikalną wartość liczbową jako osobną grupę, np. grupowanie użytkowników według wieku.
Jak używać GROUP BY w SQL?
GROUP BY używa się razem z funkcjami agregującymi, aby pogrupować wiersze według jednej lub wielu kolumn. Przykładowo: SELECT department, COUNT(*) FROM employees GROUP BY department; – zapytanie zwraca liczbę pracowników w każdym dziale.
Czym się różni GROUP BY od ORDER BY?
GROUP BY grupuje dane i pozwala wykonywać obliczenia na grupach (np. suma, średnia), natomiast ORDER BY tylko sortuje wyniki rosnąco lub malejąco. Innymi słowy: GROUP BY zmienia strukturę wyników, a ORDER BY jedynie ich kolejność