- 20 sierpnia 2026
- Posted by: Damian
- Category: Baza wiedzy
Relacyjne bazy danych stanowią fundament współczesnych systemów informatycznych – od prostych aplikacji webowych po zaawansowane systemy bankowe i analityczne. Ich popularność wynika z przejrzystego modelu organizacji danych, opartego na tabelach oraz jasno zdefiniowanych relacjach między nimi.
Co to relacyjna baza danych?
Baza danych (database) to zbiór informacji, zorganizowanych w określoną strukturę, co umożliwia przechowywanie, manipulowanie oraz zarządzanie danymi.
Relacyjne bazy danych – to bazy danych, w których dane ustrukturyzowane są w formie tabel, połączonych ze sobą za pomocą odpowiednich relacji (kluczy). Co ciekawe, podstawą relacyjnych baz danych jest teoria relacyjna, opublikowana przez Franka Edgara Codda w 1970 roku.
Podstawowe cechy relacyjnych baz danych:
- Dane przechowywane są w formie tabel,
- Baza powinna obsługiwać wartość NULL (brak czegoś),
- Konieczność zadbania o integralność przechowywanych danych.
- Za pomocą klucza, nazwy tabeli oraz kolumny, powinien istnieć dostęp do dowolnych danych.
Korzyści relacyjnych baz danych:
- Możliwość łatwego rozbudowywania baz danych,
- Umożliwienie łatwego zadbania o integralność danych,
- Wysoka szybkość dostępu do danych w obrębie bazy,
- Możliwość łatwych zmian struktury bazy danych.
System zarządzania bazami danych (DBMS – Database Management System) – to oprogramowanie komputerowe służące do przechowywania, odczytu oraz modyfikacji danych w bazach danych, np. Microsoft Access, MySQL, PostgreSQL.
SQL (Structured Query Language) – język zapytań wykorzystywany do zarządzania, modyfikacji, tworzenia oraz pobierania danych z baz danych przy pomocy odpowiedniego oprogramowania (DBMS).
NoSQL (Not Only SQL) – to nierelacyjne bazy danych pozwalające na zarządzanie i przechowywanie danych w ramach elastycznej struktury, która nie korzysta ze sztywnych tabel. Wysoka skalowalność pozioma oraz wydajność są dużym plusem w przypadku dużych zbiorów danych, tzw Big Data.
Co to jest krotka w bazie danych?
Krotka (rekord lub wiersz) – to pojedynczy wiersz w tabeli. Rekord opisuje informacje o jednym obiekcie. Wiersz składa się z pól. Każdy rekord jest zbiorem informacji odpowiadających kolumnom. Na przykład, w tabeli “Pracownicy” jeden rekord może zawierać informacje o jednym pracowniku, takie jak jego imię, nazwisko, data urodzenia, stanowisko itp. Wiersze przechowują konkretne dane, gdzie każda komórka (pole) zawiera określony przez kolumnę typ danych.
Encja – to pojęcie wykorzystywane w ramach projektowania bazy danych, gdzie encja oznacza konkretny obiekt, np pracownika, samochód czy cokolwiek innego (obiekt zawierający rózne informacje). W ramach samej bazy danych, chodzi o wiersz tabeli, czyli zbiór danych na temat danego obiektu. Przykładowo pracownik, gdzie rekord zawiera imię, nazwisko, datę urodzenia oraz stanowisko, jest przykładem praktycznego zastosowania encji.
Pole i kolumna – definicje i różnica
Pole (field) – to przecięcie kolumn w ramach tabeli, czyli komórka. To pojedyncza informacja w tabeli, np. imię pracownika.
Kolumna – w relacyjnych bazach danych, to zazwyczaj informacja związana z jakimś obiektem (np. imię, nazwisko, data urodzenia, stanowisko itd), dlatego kolumny zawierają zazwyczaj dane jednego określonego typu.
Pojęcia pola oraz kolumny bywają stosowane zamiennie, między innymi w ramach programów takich jak Microsoft Access. Wynika to właściwie z nieprawidłowego tłumaczenia, przez które te dwa pojęcia są stosowane zamiennie. Dlatego w ramach tego artykułu dla większej przejrzystości zostały podane ścisłe, odrębne definicje obu pojęć.
Czym są tabele w relacyjnych bazach danych?
Tabela (table) – to podstawowa struktura do przechowywania danych w ujednolicony sposób w ramach relacyjnych baz danych. Dane są segregowane w postaci wierszy oraz kolumn. Można to też określić jako zbiór rekordów (wierszy), z tymi samymi nazwami pól.
Struktura tabeli przypomina siatkę, gdzie:
- Kolumny (pola) – definiują atrybuty przechowywanych danych. Każda kolumna posiada nazwę oraz przypisany typ danych, który określa, jakie wartości mogą się w niej znaleźć (np. tekst, liczba całkowita, data).
- Wiersze (rekordy) – to zestawy danych, gdzie każda komórka w danym wierszu zawiera wartość określonego typu.
Do czego służy klucz podstawowy i klucz obcy – relacyjne bazy danych
Klucz podstawowy (primary key) – to identyfikator każdego rekordu (wiersza). Nazywany jest również kluczem głównym. Inaczej mówiąc jest to atrybut lub zestaw atrybutów w tabeli, który jednoznacznie identyfikuje każdy rekord w tej tabeli. Każdy rekord w tabeli musi mieć unikalny klucz podstawowy, co sprawia, że nie ma dwóch identycznych rekordów. Często są to kolejne liczby, ale może to być na przykład numer identyfikacyjny, taki jak:
- PESEL w tabeli “Osoby” (unikalny dla każdej osoby),
- Numer seryjny w tabeli “Produkty” (unikalny dla każdego produktu).
Klucz podstawowy nie może zawierać wartości NULL i nie może się powtarzać w tabeli. W momencie gdy korzysta się z klucza podstawowego z innej tabeli, nazywany jest on kluczem obcym.
Klucz obcy (foreign key) – to identyfikator rekordu (wiersza) czyli klucz podstawowy ale pochodzący z innej tabeli. Można określić to jako kopię klucza podstawowego (głównego) z innej tabeli. Klucze obce są wykorzystywane do tworzenia relacji między tabelami. Służą one do połączenia danych z różnych tabel w bazie danych. Na przykład:
- Tabela “Zamówienia” może zawierać klucz obcy odnoszący się do tabeli “Klienci”, wskazując, który klient złożył dane zamówienie.
Klucz obcy pozwala na zachowanie integralności referencyjnej, co oznacza, że nie można dodać do tabeli wartości w kluczu obcym, które nie mają odpowiadającego klucza podstawowego w tabeli, do której się odwołują.
Jak tworzone są relacje pomiędzy tabelami?
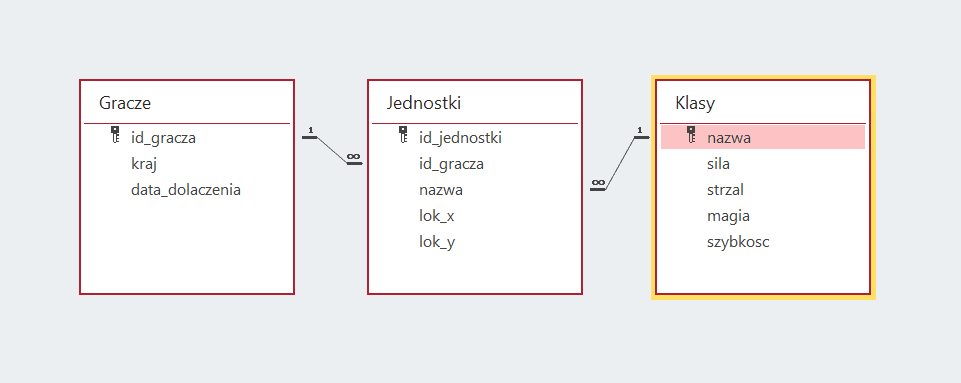
Relacja to powiązanie między dwiema lub większą ilością tabel w bazie danych, co pozwala na wspólne przechowywanie danych. Relacje są tworzone przez klucze obce i umożliwiają połączenie danych z różnych tabel. Istnieją różne typy relacji, w tym:
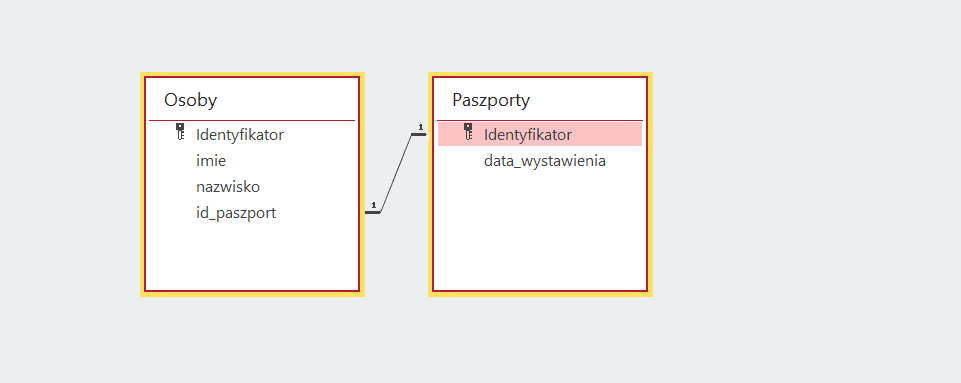
- Relacja jeden do jednego (1:1) – gdy jeden rekord w jednej tabeli jest powiązany z jednym rekordem w innej tabeli (np. tabela “Osoby” i tabela “Paszporty”). Taki typ relacji jest rzadko stosowany, bo większość tego typu informacji byłoby zawartych w ramach jednej tabeli.
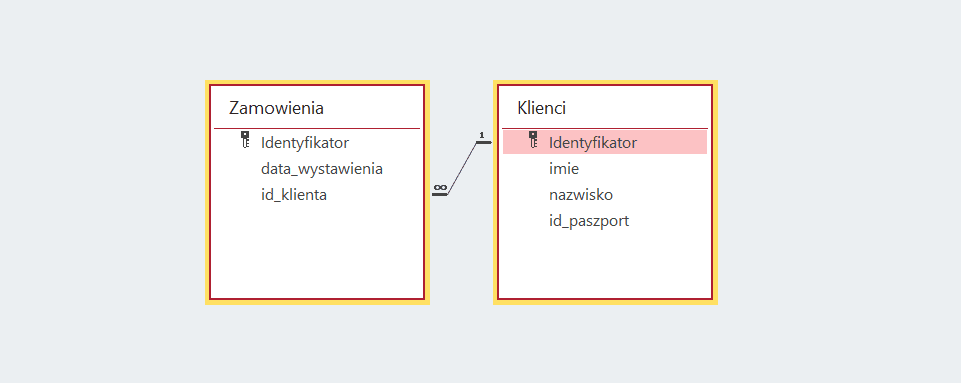
- Relacja jeden do wielu (1:N) – gdy jeden rekord w jednej tabeli może być powiązany z wieloma rekordami w innej tabeli (np. tabela “Klienci” i tabela “Zamówienia”). Najczęstszy typ relacji.
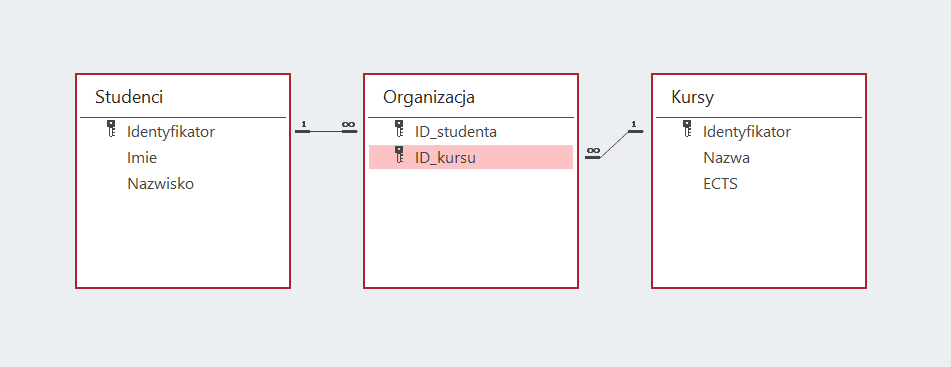
- Relacja wiele do wielu (N:M) – gdy rekordy w obu tabelach mogą być powiązane z wieloma rekordami w drugiej tabeli (np. tabela “Studenci” i tabela “Kursy”, gdzie jeden student może zapisać się na wiele kursów, a jeden kurs może mieć wielu studentów). Jednak realnie, tworzona jest po prostu trzecia tabela “Organizacja”, gdzie tabela “Studenci” ma relację jeden do wielu z tabelą “Organizacja”, a tabela “Kursy” ma relację jeden do wielu z tabelą “Organizacja”, co ostatecznie tworzy relację wiele do wielu pomiędzy tabelą “Studenci” i “Kursy”.
Do czego służy kwerenda (zapytanie)?
Kwerenda to zapytanie umożliwiające interakcję z danymi w bazie danych. Pozwala na wyświetlenie pól i rekordów z tabel według kryterium ustalonego przez użytkownika. Kwerenda służy też do porządkowania danych, wykonywania obliczeń i aktualizacji danych.
Dzięki zapytaniom można:
- Pobierać dane – za pomocą SELECT, aby uzyskać dane z jednej lub wielu tabel.
- Wstawiać dane – za pomocą INSERT, aby dodać nowe rekordy.
- Aktualizować dane – za pomocą UPDATE, aby modyfikować istniejące rekordy.
- Usuwać dane – za pomocą DELETE, aby usuwać rekordy z tabeli.
Kwerendy są formułowane za pomocą języka SQL (Structured Query Language), który jest standardowym językiem zapytań do relacyjnych baz danych. SQL umożliwia precyzyjne operacje na danych, filtrowanie wyników, sortowanie, łączenie tabel oraz agregowanie danych.
Dzięki zapytaniom możemy pracować z danymi w bazie, a także zapewnić ich spójność i integralność.
Formularz służą jako wygodny interfejs, który pozwala uprościć proces wprowadzania, przeglądania i aktualizacji danych.
Raport to prezentacja określonych informacji z bazy danych, przedstawiane są w ramach formatów cyfrowych lub wydruków.
Sortowanie to proces uporządkowania rekordów (wierszy) w ściśle określony sposób, np. rosnąco lub malejąco.
Najczęściej zadawane pytania o podstawy baz danych
Jakie są 5 głównych komponentów bazy danych?
Pięć podstawowych komponentów systemu bazodanowego to: sprzęt (hardware), czyli fizyczna infrastruktura (serwery, dyski); oprogramowanie (software), w tym system zarządzania bazą danych (DBMS) jak MySQL czy PostgreSQL; dane (data), czyli właściwa zawartość bazy; procedury (procedures), czyli zasady i instrukcje korzystania z systemu; oraz użytkownicy (people) – administratorzy, programiści i końcowi użytkownicy.
Każdy z tych elementów jest niezbędny: dane są centralnym zasobem, DBMS umożliwia ich obsługę, sprzęt zapewnia działanie, procedury porządkują pracę, a użytkownicy faktycznie korzystają z systemu.
Jakie są podstawowe właściwości baz danych?
Podstawowe właściwości baz danych to przede wszystkim spójność, integralność, bezpieczeństwo oraz minimalizacja redundancji (nadmiarowości danych). Oznacza to, że dane są poprawne, niepowielane bez potrzeby i chronione przed nieautoryzowanym dostępem.
Dodatkowo ważne są: trwałość danych, współbieżność (możliwość pracy wielu użytkowników jednocześnie) oraz zgodność z zasadami ACID (atomowość, spójność, izolacja, trwałość), które gwarantują niezawodność operacji na danych.
Z czego składa się baza danych?
Baza danych składa się głównie z tabel (relacji), które zawierają dane w postaci wierszy (krotek) i kolumn (atrybutów). Oprócz tego obejmuje elementy takie jak klucze główne i obce, które zapewniają identyfikację rekordów i powiązania między tabelami.
W praktyce baza danych zawiera także inne obiekty: indeksy (przyspieszające wyszukiwanie), widoki (views), zapytania (queries), a w niektórych systemach również procedury składowane i wyzwalacze (triggers), które automatyzują operacje na danych.